把 MOSS-Image 装进本地 ComfyUI:差一天就不支持的核心版本
“最近有个 MOSS-Image 的绘图模型很火,你看看能不能部署到本地。“——一句话的任务,半天的工作量。
这篇是这一趟的完整记录:从”当前 ComfyUI 根本装不下它”,到升级、下权重、跑通,再测出它真实的能力边界。
一、先搞清楚它要什么
MOSS-Image(OpenMOSS,2026-10 发布)的结构:5B 单流 DiT + Qwen3.5-9B 文本编码器 + FLUX.2 的小 VAE,Apache-2.0。
它的卖点和常见出图模型不一样:中英文字渲染、JSON layout 定位(用 bbox 指定元素位置)、4K token 长 prompt。
本地要跑起来,三件事:
- ComfyUI 核心得支持它——这是最大的坑,见下一节;
- 权重三个文件合计 ~15.4GB(国内可直连镜像);
- 显存:文本编码器 9GB 级 + DiT 5GB 级,峰值实测 14.4GB。
二、最大的坑:核心版本差一天就不支持
MOSS-Image 的 ComfyUI 支持来自两个 PR:#17095(10-16 合并) 和 #17099(10-17,situ 融合)。
而这台机器上的 ComfyUI 是 v0.33.0-28,落后 master 369 个 commit——原版完全不支持这个模型。
更别扭的是稳定版也不行:v0.41.2 比支持 MOSS 的那个 PR 还早 11 小时,升上去照样是”类型不认识”。
所以只有两条路:cherry-pick,或者升 master。我先走的是 cherry-pick:
cd /d/ComfyUI && git fetch origin
git cherry-pick -n e087d8f6      # 不提交,先解冲突
冲突只有两处,而且不能照抄上游的枚举值:
comfy/sd.py的CLIPType:上游是YUE2=36 / FLUX3=37 / MOSS_IMAGE=38,但本快照 35 之后是空的,所以只加MOSS_IMAGE = 36。nodes.py的CLIPLoader类型列表:只追加"moss_image",不要加 yue2 / flux3——那两个模型目录本快照根本没有。
紧接着撞上的是缺失的上游 API,这是 cherry-pick 的常规代价:
comfy/configurable.py在本快照里不存在(上游后来才引入),但comfy/ldm/moss_image/model.py依赖它提供的ComfyAttention。偏偏 int8 权重里带着layers.N.comfy_attention.config键(42 层,值是{"attention": "comfy_kitchen_int8"}),必须有东西接住它。解法是就地实现:在attention.py里定义ComfyAttention,在_load_from_state_dict里把config键弹出来json.loads成实际策略,命中 int8 时挂上attention_comfy_kitchen_int8;同时给 attention 包装器加一个preferred_attention出口。comfy.model_prefetch里的malloc_graph_begin/end、prefetch_queue_pop(..., malloc_scope=)这套参数在旧快照里没有——删掉这几处,保留make_prefetch_queue即可。- 本机的
comfy_kitchen 0.2.31没有 sol attention(sol_attn_is_available()返回 False),所以只需要接 int8 分支,不用管另一条。
补完这一套,模型能加载了。
三、权重:走国内镜像,断点续传
| 文件 | 大小 | 目标目录 |
|---|---|---|
moss_image_sft_int8_convrot.safetensors | 5.41 GB | models/diffusion_models/ |
qwen3.5_9b_int8_convrot.safetensors | 9.75 GB | models/text_encoders/ |
flux2-vae_small.safetensors | 249 MB | models/vae/ |
hf-mirror.com 直连速度足够,用 curl -L -C - --retry 20 断点续传。
注意 ModelScope 的镜像目录里没有那个小 VAE,别只从一个源拉。选 int8 量化版而不是 bf16 DiT(10.16GB),文本编码器也还有 w4a8 GPTQ(7.34GB)可选——目标是在单卡 32GB 显存里同时装下”9GB 文本编码器 + 5GB DiT”。
四、工作流:官方模板 + 一个 API 陷阱
直接用官方模板(含子图,比手搓省事),下下来把节点里的三个文件名改成实际的即可。
API 提交有个坑:CreateBoundingBoxes.editor_state 是 socketless 的 widget,bboxes 输入也不能直接喂 list(会被判 bad_linked_input)。所以要玩 layout(指定元素位置)就别接这两个 UI 节点,直接构造 layout JSON 塞进文本编码节点:
{"summary": {"caption": prompt},
 "items": [
    {"label": "text",   "caption": desc, "text": "要渲染的字", "bbox": [y0, x0, y1, x1]},
    {"label": "object", "caption": desc, "bbox": [...]}],
 "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}
bbox 是 0-1000 归一化的 [y0,x0,y1,x1],转换规则 floor(round(v*size/1000, 9)) - size//2,也就是相对画布中心的像素边界——这条抄自源码,别自己推。
五、实测:16 秒一张,中文零错字
采样参数用模型自带的:er_sde / simple / shift 5;步数和 CFG 两档,快档 25 步 CFG 2.5。分辨率上总像素 1M / 1.5M / 2M 最佳(0.25M~4M 可用,宽高须为 16 的倍数)。
- 1024×1024 / 25 步 ≈ 16 秒(RTX 5090,含加载),显存峰值 14.4GB。
中文渲染是它真正的卖点,实测站得住:
 中文文字渲染实测,零错字(“山城夜色” / “贵阳 · 2026 秋冬”)
layout 模式四个框(黑英文 / 红中文 / 对象 / 底部小字)全部落位正确:
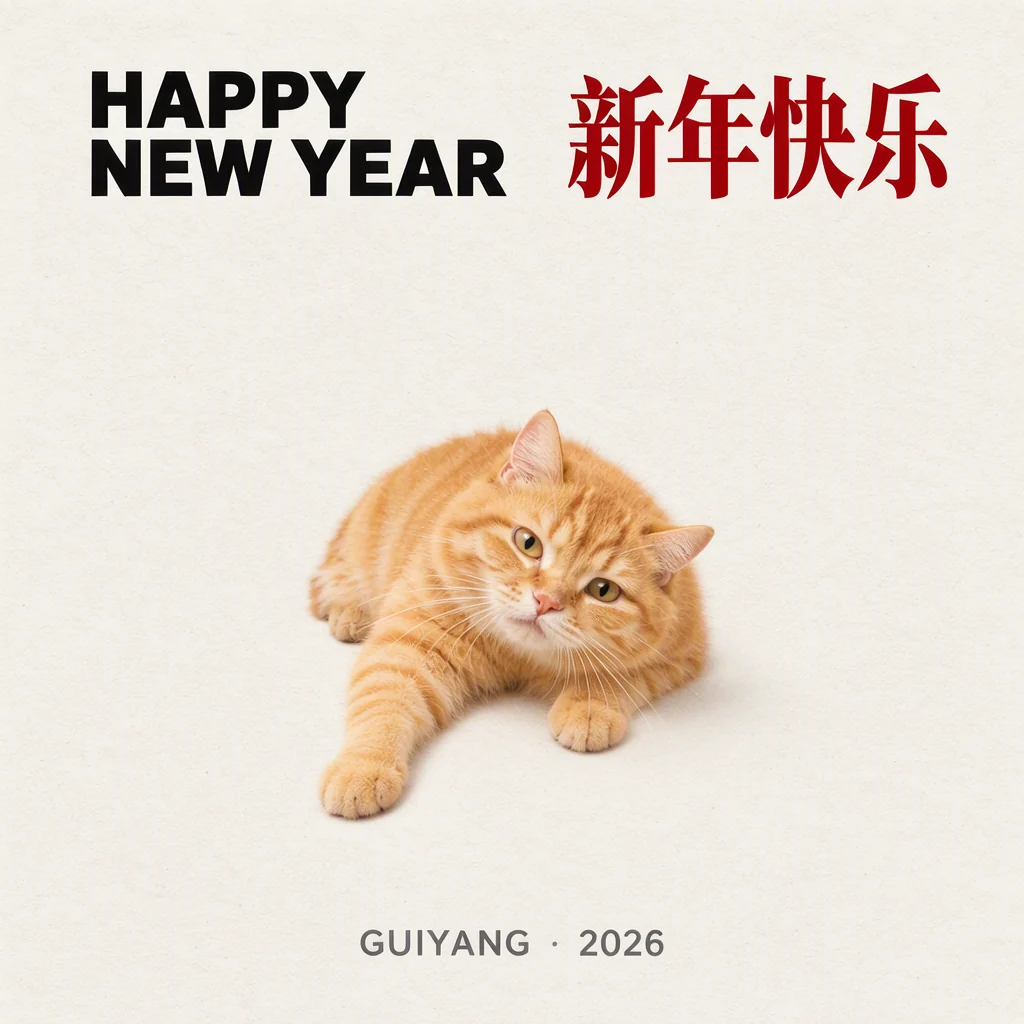 layout 模式:四类元素按 bbox 落位
六、然后我拿它出了一张多角色图,撞到了天花板
中文没问题之后,试了一张更贪心的:六人同框,1536×1152 / 30 步 / CFG 3。
结果是教科书式的:
能做到的:人数对、每人的光环对、每对不同颜色的泳装、站位不粘连。
崩掉的:手。握道具的手指和道具融在一起、交叉的手臂糊成一团、脚趾并成色块;发色、瞳孔这类设定细节也会漂。
试过压:把 bad hands, extra fingers, missing fingers 写进负向、步数提到 50、CFG 提到 3——收效有限。5B 的容量天花板摆在那里,不是提示词能绕过去的。
判断很直接:
- 甜点区:单个/双角色 + 大量文字的场景——海报、招牌、漫画格、带字的插图。
- 不该用它:密集多角色、写实、精细手脚。多角色请换 FLUX.2 / Qwen-Image,或先查本地有没有对应角色的 LoRA。
七、顺带把核心升到 master
cherry-pick 能跑之后,为了摆脱手工补丁,还是把核心升了:v0.33.0(含手工 cherry-pick)→ 0.41.0(上游原生)。依赖跟着升:前端 1.49.6 → 1.55.18,comfy-kitchen 0.2.31 → 0.2.38。
为什么升 master 而不是 v0.41.2 稳定版:稳定版比 MOSS 支持的那个 PR 还早 11 小时,升上去 MOSS 直接失效。
升级后重新冒烟:17.56 秒出图(升级前 20 秒,新核心带编译器优化);12 个 diffusion_models 全在,21 个 custom_node 正常加载,moss_image 编码器类型在位。
模型、工作流、custom_nodes、output 全在 .gitignore 里,升级过程零接触。
八、结论
一句话:它是”带文字的图”的专用工具,不是万能出图模型。
- 要出海报、招牌、带标题的插画、漫画格——本地首选出它:16 秒一张、中文零错字、位置可由 bbox 指定;
- 要出角色立绘、群像、精细手部——它是错的工具,换支持参考图的模型(Qwen-Image-Edit / FLUX.2 那类),或者配角色 LoRA。
分清这两件事,能省掉一整轮”为什么怎么调词都不对”的困惑。
顺带一条环境经验:这类新模型的部署卡点,八成在核心版本而不是权重或显存。 先查”支持它的那个 PR 是什么时候合并的、我的核心在哪一天”,比先下 15GB 权重省时间。