同一张图跑了五版:六人同框出图的迭代记录
需求是一句话:“六个人一起在海边”。
结果是五版。种子固定 777001,尺寸固定 1536×1152(1.77M 像素,横构图),模型固定(MOSS-Image,30 步 / CFG 3 / er_sde+simple),每版只改描述词。
这篇把五版逐版记下来——包括每一版改了什么、为什么改、以及模型是怎么自作主张的。
一、五版总览
| 版本 | 单张耗时 | 提示词长度 | 这一版改了什么 | 结果 |
|---|---|---|---|---|
| v1 | 20 s | 1220 字符 | 首版 | 六人齐,但多个角色设定错 |
| v2 | 20 s | 1248 字符 | 某角色发长:短发 → 过腰长发 | 改对;其余五位同种子基本一致 |
| v3 | — | 1276 字符 | 某角色:长发 → 黑色短发波波头 | 改对 |
| v4 | 18 s | 1439 字符 | 三处设定重写(按用户给的造型图核对) | 设定改对了,人数变成 7 个 |
| v5 | 18 s | 1412 字符 | 显式计数 + 负向压重复角色 | 六人对,设定对上 |
注意一个数字:提示词长度从 1220 涨到 1412,只多了 15%,但这 15% 全是”人”的约束。
二、v1 → v2 → v3:改描述词就够了
第一版六个人都在,但设定错了。用户给的反馈非常具体,都是可直接翻译成词的:
- “某角色的头发应该是过腰的长发” → 把
hair的描述从短改成very long ... hair with an ahoge reaching past her waist; - “这个角色是短发” → 改成
short hair in a bob cut。
同种子重跑,改动只影响被改的那个角色,其余五位基本保持一致——这是固定种子迭代的好处:你改了什么,一眼能看出来。
v2 之后还有一处细节值得记:用户给的造型图,在这条路线上只能用来改文字。因为 MOSS-Image 是纯文生图 DiT,没有图片输入——它吃不下参考图。想要”照着图还原”,得换支持参考图的模型(图生图路线),这是两条不同的技术路线,不是同一个模型的参数问题。
顺带一个视觉模型的小坑:让视觉模型描述用户发来的造型图时,它把角色身份认错了(认成了别的作品的别的角色)。所以核对身份这件事不能交给视觉模型,要靠用户口述的特征(发色 / 发长 / 眼镜 / 光环形状)来对。视觉模型看”结构”(几个人、有没有粘连、手崩没崩)是够用的,看”这是谁”不可靠。
三、v4:设定全改对,人数变成 7 个
v4 按用户给的造型图重写了三处:
- 第二位:“她其实是第一名角色的成年版”,所以不是黑头发——改成”一位高挑的成年女性,超长银白长发、灰狼耳、破碎的黑色光环、深藏青泳装、平静表情;
- 第五位:双马尾,垂到腰;
- 第六位:黑色短发 + 红框眼镜。
三处全改对了。但同一版里,画面里出现了 7 个人。
原因很典型:为了让”成年版”能被认出来,我在提示词里同时写了成年版的名字和原角色的名字。模型没有”这两个是同一个人的不同版本”这个概念——它读到两个名字,就画了两个人。
四、v5:把”人数”变成一个可以约束的东西
修法是两条,一起上:
1. 显式计数,并把顺序编号写进提示词
"exactly six girls, 6 characters, a group of six ... students ... on a beach,
 from left to right standing in a loose row of six:
  1st girl <角色描述>,
  2nd girl <角色描述>,
  ...
  6th girl <角色描述>,"
2. 负向词里直接排他
负向词加上:extra girls, seven girls, duplicate character。
同种子重跑,回到 6 个,而且三处设定改动全部保留(第二位不再是黑发、第三位过腰长发、第五位双马尾垂腰、第六位短发还连眼镜都补上了)。
这里有一条可复用的经验:当画面里”某个东西的数量”很重要时,别指望模型自己数。 显式声明数量(exactly N)+ 逐个编号(1st/2nd/...)+ 负向排他(把”多出来”写成负面词),三件一起做,比只做其中一件有效得多。
五、五张图
v1 首版(六人齐,多个角色设定错):
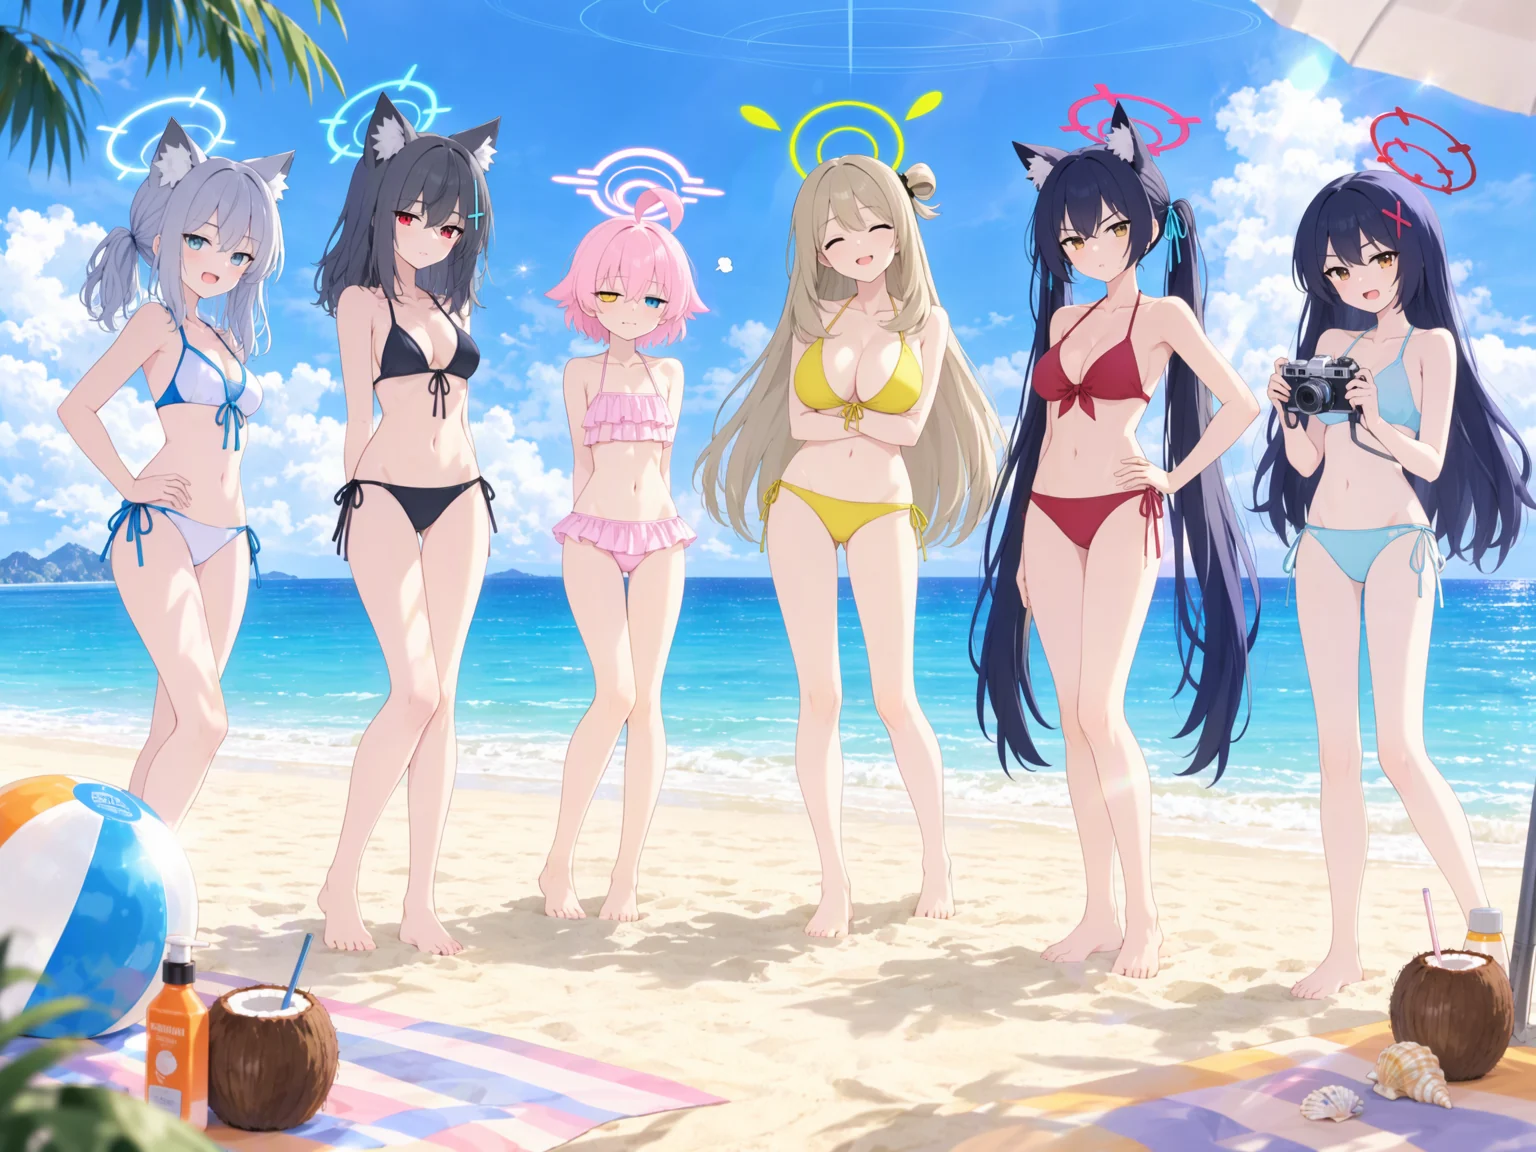 v1:六个人都在,但发型发色有多处不符
v2 某角色改长发:
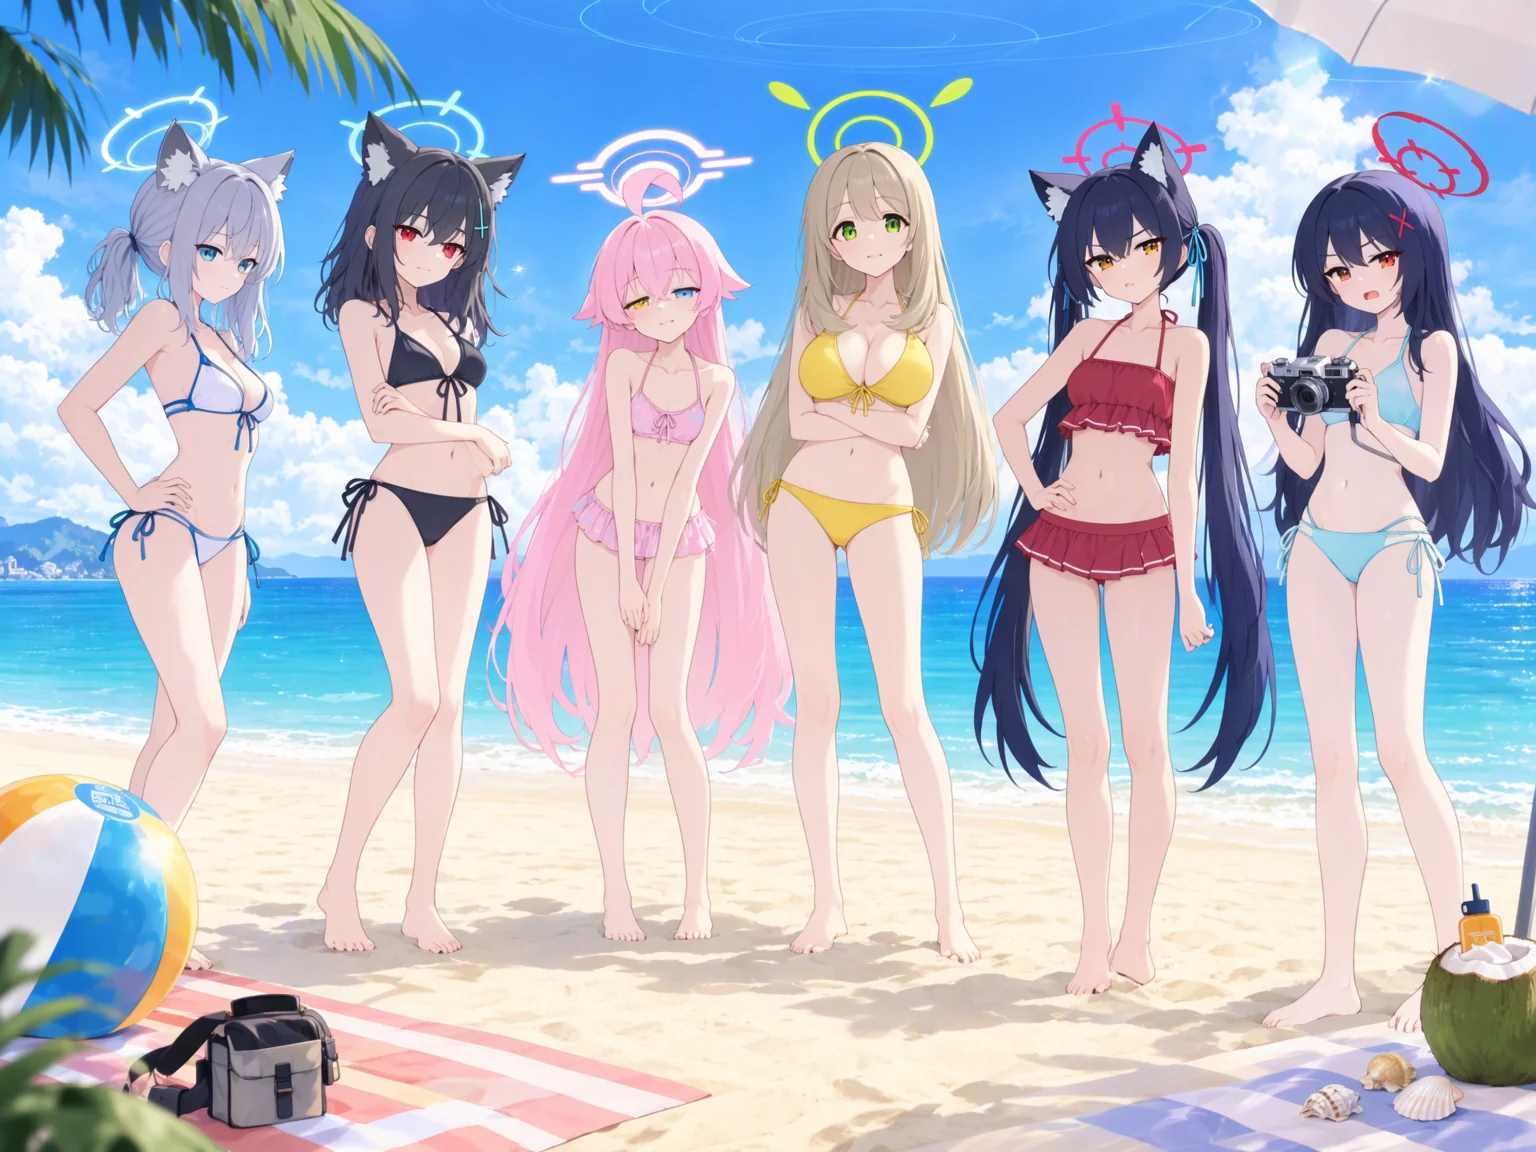 v2:该角色的头发从短发改为过腰长发,其余五位同种子基本一致
v3 另一角色改短发波波头:
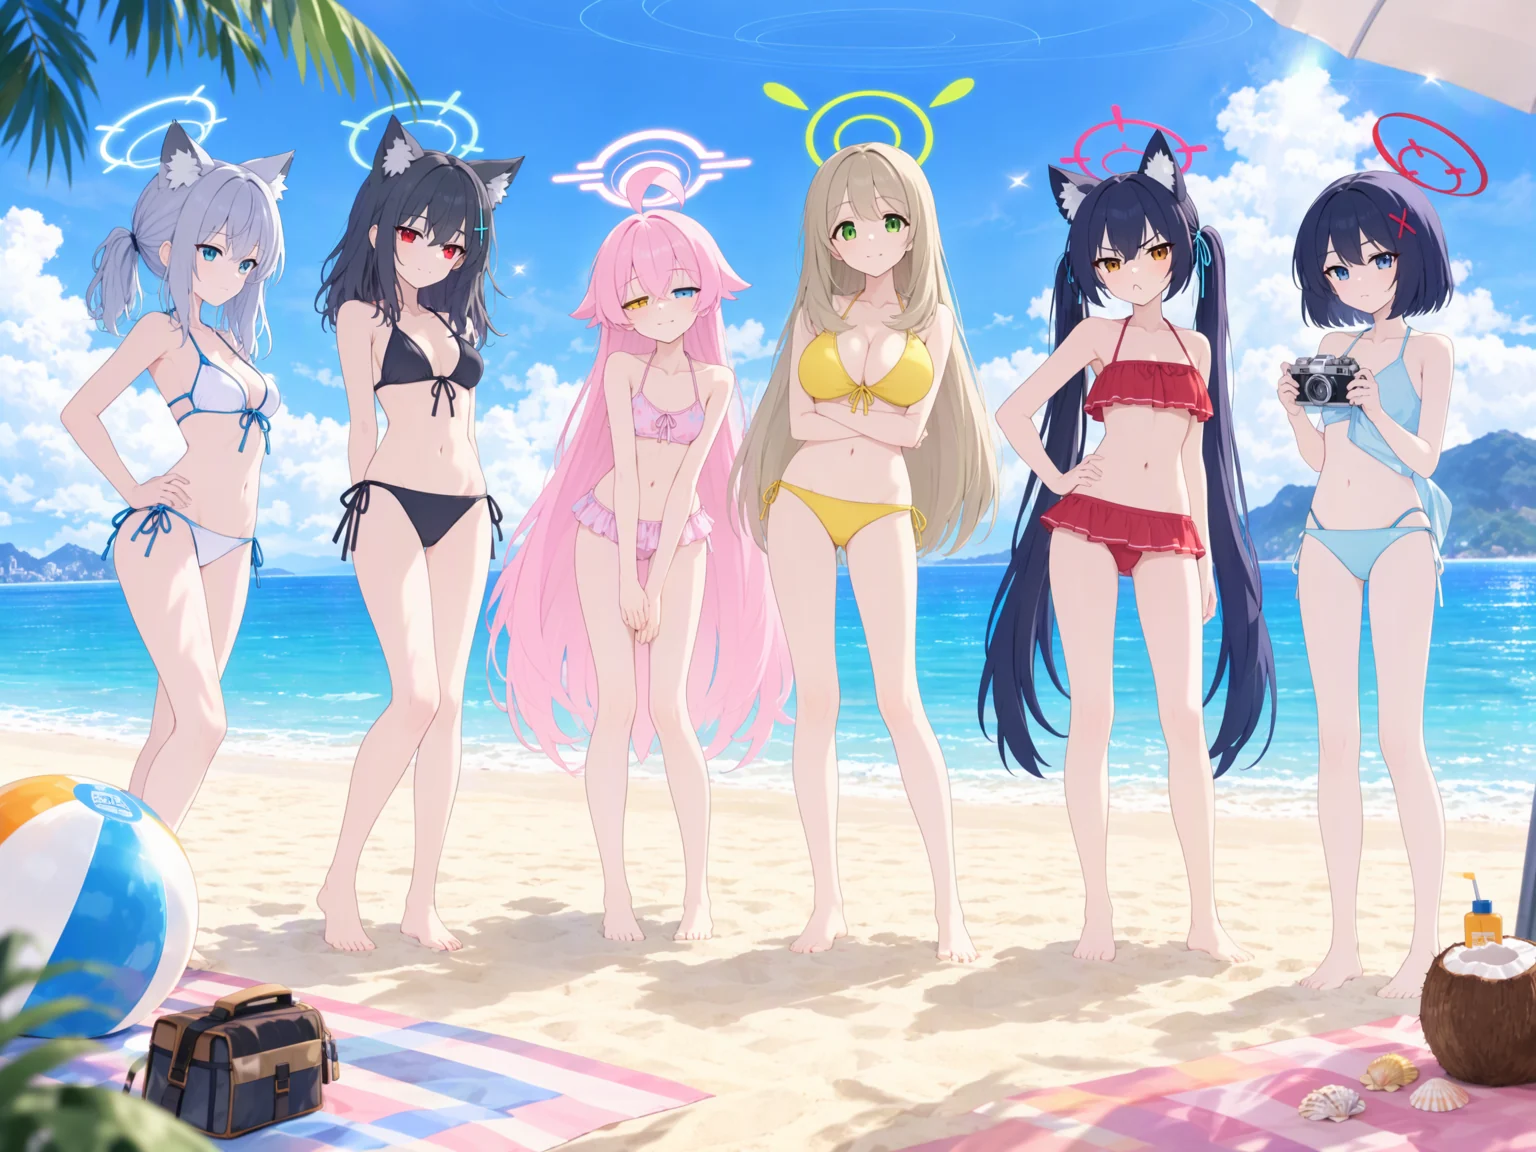 v3:另一位改成黑色短发波波头
v4 设定改对,但多出一个人:
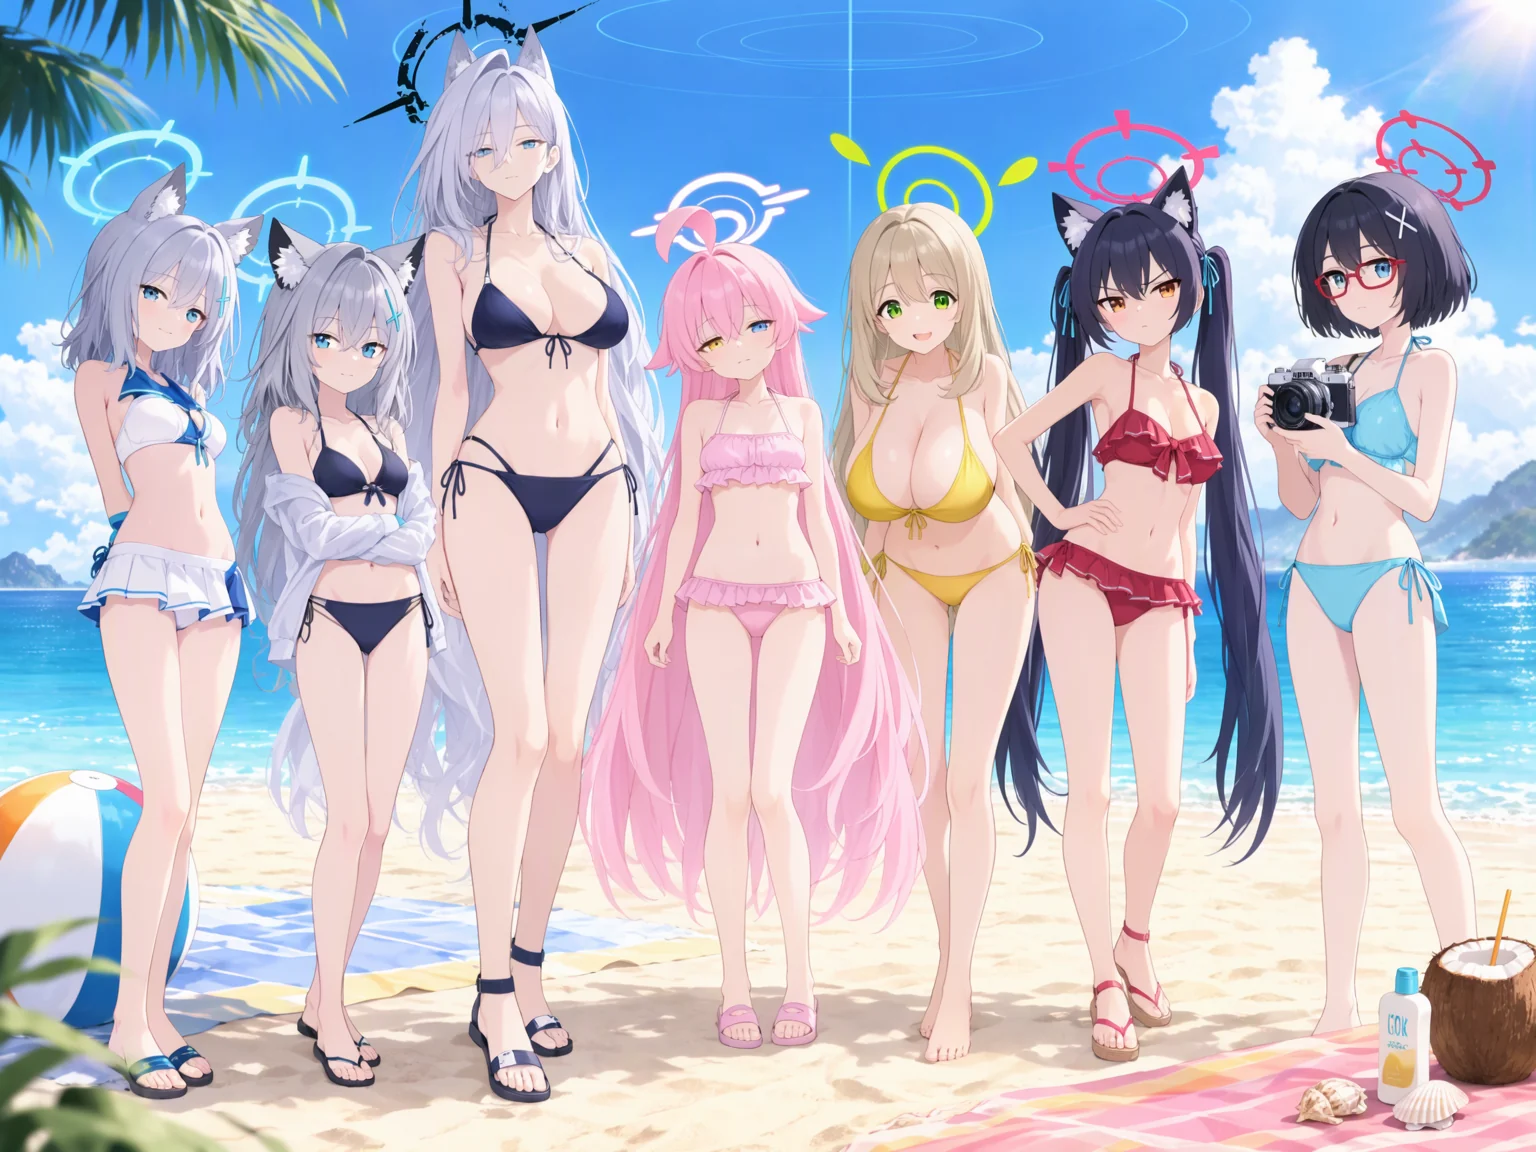 v4:三处设定都改对了,但画面里出现了 7 个人(同一个角色的两个版本被当成两个角色)
v5 定版(六人对,设定对上):
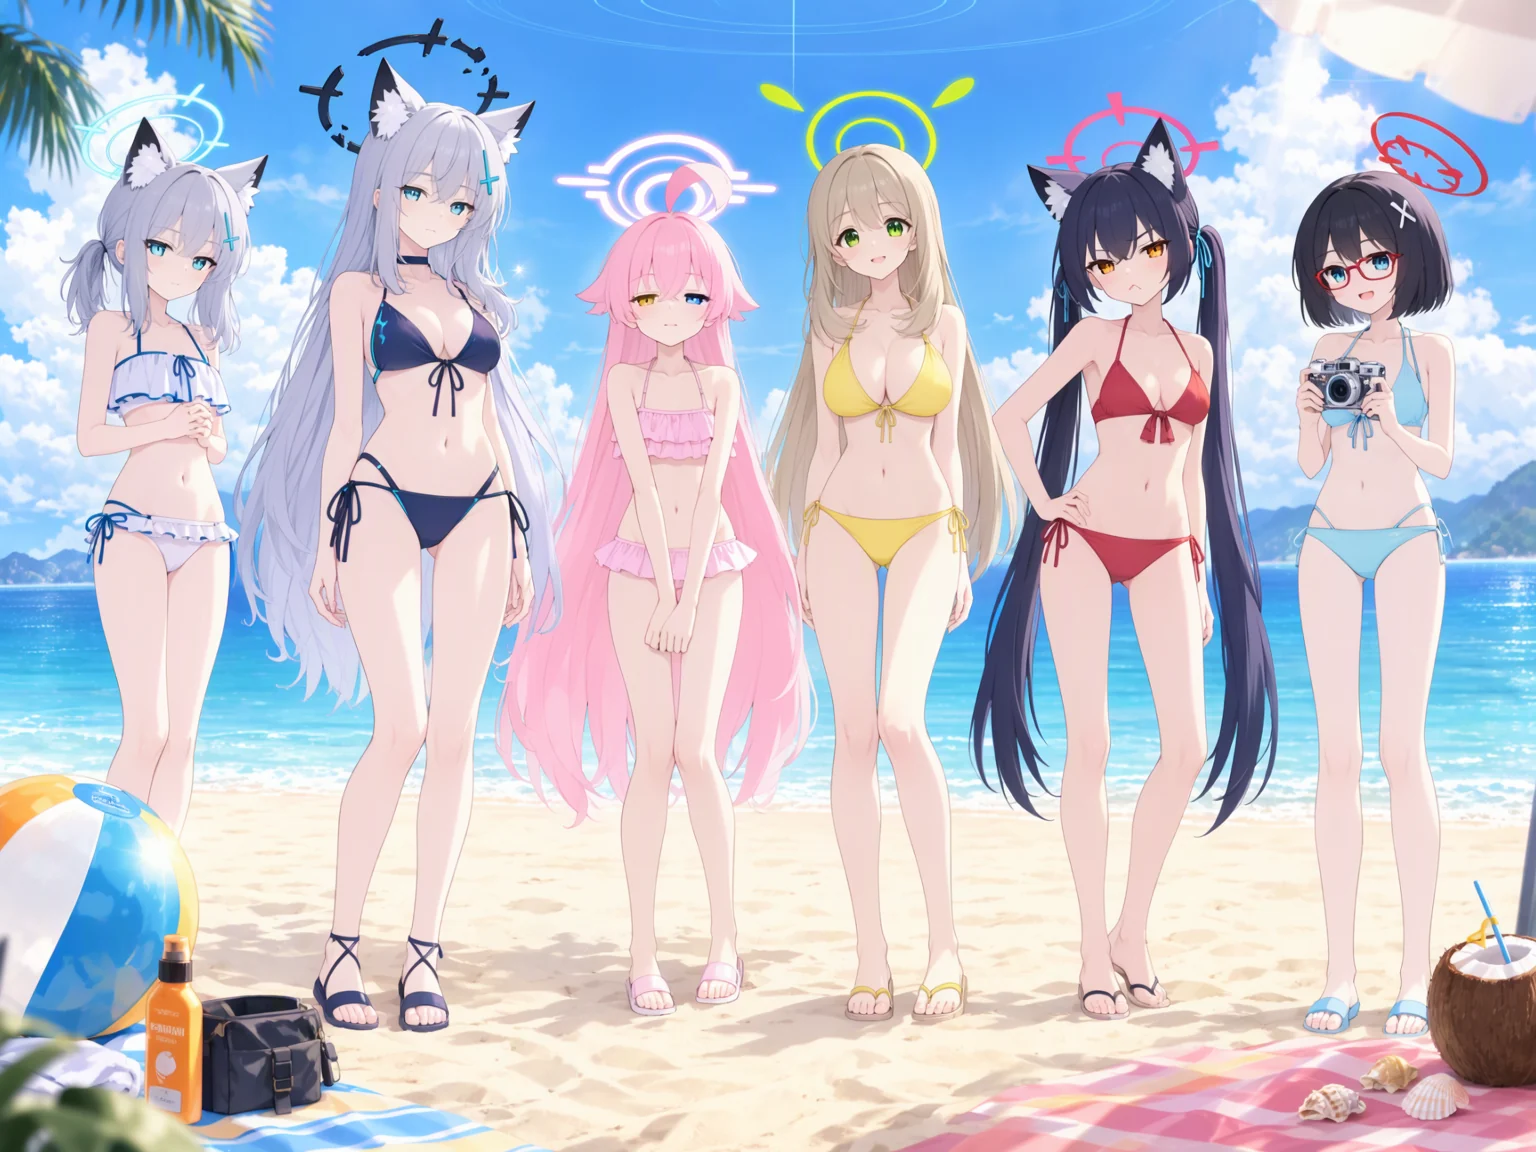 v5:显式计数 + 负向排他之后回到六人,三处设定改动全部保留
六、仍然没解决的两处
定版也不是完美的,还有两处小偏差,最后决定不再追:
- 第一位角色的发型画成了偏短(原设是长发);
- 第二位角色少了我明确要求的”破碎黑色光环”。
为什么不追了:这两处都属于模型容量层面的漂移,不是提示词能稳定钉住的。已经验证过的结论是——这个模型在这一档分辨率下的甜点区是单个/双角色 + 大量文字,六个人同框已经在它的能力边上:人数和配色能对上,细节设定会漂,手部会崩。
继续磨提示词的边际收益很低。要真想要”六个人各自精准”,正确做法是换成支持参考图的模型(每个角色单独给参考),或者干脆拆成六张单人图再拼——这也算是这次迭代最后得出的方法论:与其和一个不擅长多角色的模型死磕,不如改变任务的形状。
七、这次迭代留下的三条
- 固定种子迭代:每一版只改”人”的描述,能立刻看出改动生效了没有。
- 数量要显式约束:
exactly N+ 逐个编号 + 负向排他,三件一起做。 - 认清模型边界比调词重要:当问题是”六个人各自精准”,而模型的天花板是”人数对、细节漂”,那就不该继续在提示词上投入,应该换工具或换任务形状。
五版、约 94 秒总出图时间,最后交付的是一张可用图 + 一份知道自己该用在哪的边界认知。后者更值钱。